关于大数据服务应该了解的一切 深入解析数据处理服务
在数字化时代,数据已成为企业的核心资产之一。海量、多源、异构的数据本身并不直接产生价值,只有通过专业的大数据服务,特别是数据处理服务,才能将原始数据转化为可操作的洞察。本文将带您全面了解大数据服务中数据处理服务的定义、关键环节、技术栈、应用场景以及选型建议。
一、什么是数据处理服务?
数据处理服务是大数据服务的重要组成部分,指对采集到的原始数据进行清洗、转换、整合、分析等一系列操作,使其成为高质量、可分析的数据资产的专业服务。它通常涵盖数据采集与预处理、数据存储与管理、数据计算与加工、数据分析与挖掘等环节,目标是提升数据质量、降低数据复杂度,并为上层应用(如BI、AI模型)提供可靠输入。
二、数据处理服务的核心环节
- 数据采集与预处理:从业务系统、日志、传感器、第三方API等源头抽取数据,并进行格式统一、去重、补全等初步处理。
- 数据清洗:识别并处理缺失值、异常值、重复记录和噪声数据,确保数据准确性和一致性。
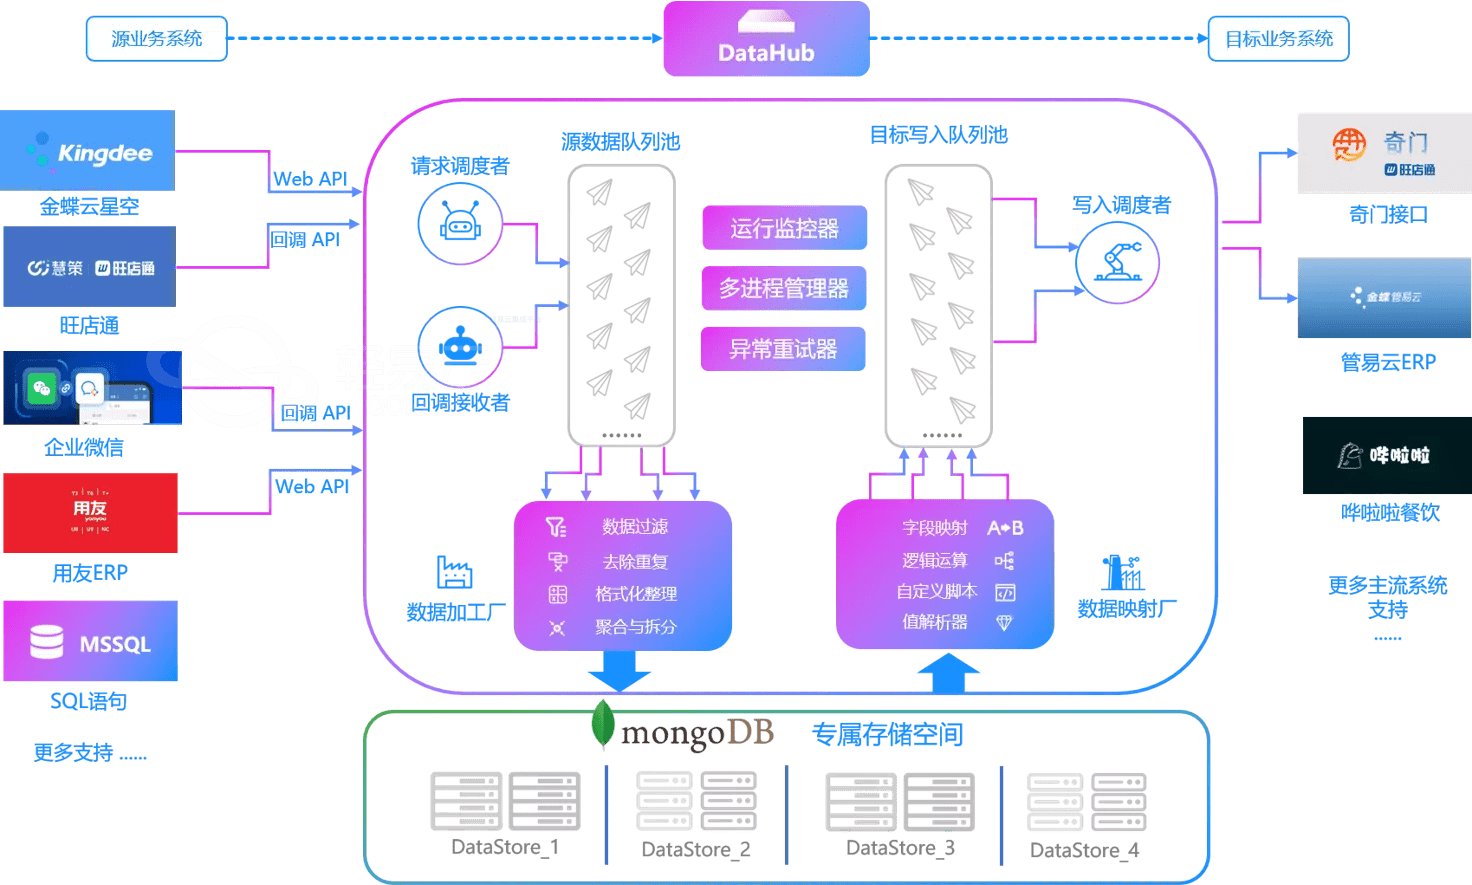
- 数据转换与整合:通过ETL(抽取-转换-加载)或ELT流程,将不同来源的数据按照业务规则进行映射、聚合、关联,形成主题域或宽表。
- 数据存储与管理:根据数据热度与结构,选择关系型数据库、NoSQL、数据仓库、数据湖或湖仓一体架构进行存储,并实施元数据管理、数据血缘追踪。
- 数据计算与加工:利用批处理(如Spark、Hive)或流处理(如Flink、Kafka Streams)技术,完成大规模数据聚合、指标计算和特征工程。
- 数据分析与挖掘:通过SQL查询、统计分析、机器学习算法,发现模式、趋势和关联,输出报表、标签或预测模型。
- 数据治理与安全:贯穿全流程的数据质量监控、权限控制、脱敏加密和合规审计,保障数据可信与安全。
三、主流技术栈与工具
- 批处理:Apache Hadoop、Spark、Hive、Presto
- 流处理:Apache Flink、Kafka Streams、Spark Streaming
- 数据集成:Apache NiFi、Airflow、DataX、Debezium
- 数据存储:HDFS、HBase、Cassandra、Amazon S3、Delta Lake、Iceberg
- 数据仓库:Snowflake、BigQuery、Redshift、ClickHouse、Doris
- 数据治理:Apache Atlas、DataHub、Great Expectations
四、典型应用场景
- 用户行为分析:清洗埋点日志,构建用户画像与漏斗模型。
- 实时风控:流式处理交易数据,实时识别欺诈行为。
- 供应链优化:整合多源订单与库存数据,预测需求并优化补货。
- 物联网数据处理:对传感器时序数据进行降噪、聚合与异常检测。
- AI模型训练:为机器学习提供高质量的特征数据集。
五、如何选择数据处理服务?
企业在选型时需考虑:数据规模与增长预期、实时性要求、现有技术架构兼容性、团队技能储备、成本(包括计算与存储)、以及供应商的生态与支持能力。对于大多数企业,采用云原生托管服务(如AWS Glue、阿里云DataWorks)可降低运维复杂度;对数据主权要求高的场景,则可选择私有化部署方案。
六、趋势展望
数据处理服务将呈现以下趋势:湖仓一体架构普及、DataOps理念落地、AI增强的数据处理(如自动数据清洗与特征发现)、以及更严格的隐私计算与合规要求。企业应持续关注技术演进,构建弹性、可治理的数据处理能力。
大数据服务的价值核心在于数据处理。理解其环节、技术与最佳实践,是企业释放数据价值的关键一步。
如若转载,请注明出处:http://www.qnzby2973.com/product/89.html
更新时间:2026-11-21 15:45:18